
Strata for Mac 版
Strata:这款开源工具可以让普通电脑,尤其是显存有限的消费级显卡,也能运行参数规模惊人的本地 AI 大模型,比如 Qwen3.8、Qwen-Flash-Next、DeepSeek 4.1 Flash 等模型。
Strata 是什么
核心在于让本地模型真正可用。Strata 提供了 Qwen3.8-Flash-Next、Qwen3.6-35B-A3B、DeepSeekV4.1-Flash-1017 等模型选择,并给出显存需求与兼容性参考。以 DeepSeekV4.1 为例,放不进内存的部分会从 SSD 读取,因此需要充足的磁盘空间;它可在 NVIDIA RTX 30/40/50 系(Windows、Linux)、AMD Radeon AI PRO R9700(Linux)、AMD Ryzen AI Max Strix Halo(Windows)以及 64GB 以上内存的 Apple Silicon Mac 上运行。桌面端把聊天、文件和实时预览放在同一窗口,终端用户执行 strata launch 即可按提示下载并启动模型。
它适合希望数据留在本机、不想依赖云端服务的开发者和技术用户,尤其是需要在本地跑代码助手或图像工作流的人。
详细介绍
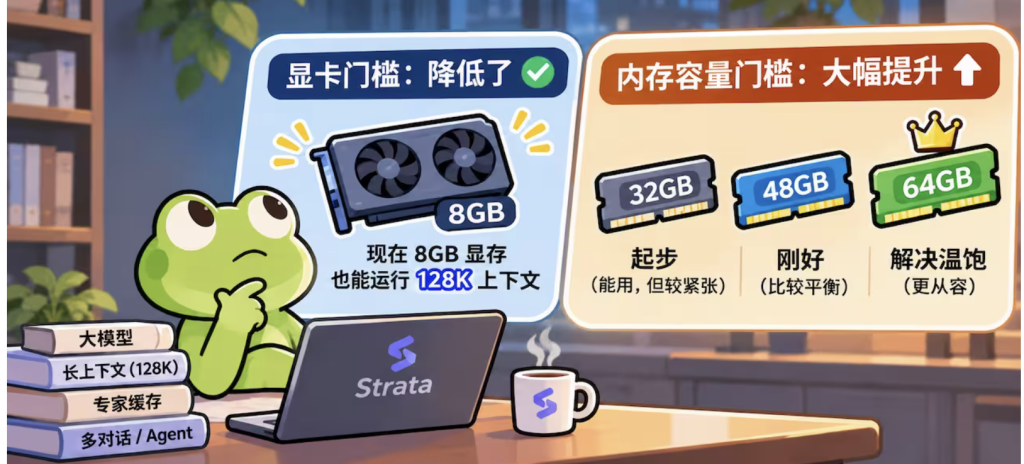
以前在 8GB 显卡下,开启 64K 上下文会耗尽专家缓存空间,导致启动失败。只能改用 CPU 图像处理、更小的 KV 缓存,或将上下文降到约 48K。
Strata 0.2.10 改进了这套机制:当显存不足时,优先调整显存和内存之间的数据分配,尽可能保留用户设置的上下文长度。
比如,现在可以在 8GB 显存条件下启动 Qwen3.8 IQ3_S,并保持 128K 上下文,也就是 131,072 Token。
Strata 会根据显存余量,逐步缩小驻留在 GPU 中的 KV 缓存窗口,必要时还会调整其他缓存,甚至将部分数据放到系统内存中。
官方测试中:
- 8GB 显存限制下,DFlash2 模式生成速度达到 63~73 Token/s。
- 32K Token 的提示词处理时间为 19.8 秒。
- 一张真正的 Intel Arc A750 8GB 显卡,也成功启动 128K 上下文,生成速度为 12.7~14.8 Token/s。
注意,显存需求仍然在,不是凭空消失,而是把压力给到了内存和 SSD。
Strata 0.2.10 将 DFlash2 设置为默认加速器。
DFlash2 是一种推测解码器。简单理解,就是让一个体积较小的辅助模型提前猜测接下来可能生成的内容,再交给主模型批量验证。猜对的部分越多,主模型就越有机会一次确认多个 Token,从而加快生成速度。
此前 Strata 使用的 MTP 推测层大约需要 5.2GB 空间,而新版 DFlash2 的显存占用约为 625MiB。
官方对比了同一引擎下 DFlash2 和 MTP 的表现:
| 测试设备 | 模型 | 生成速度提升 |
|---|---|---|
| Ryzen AI Max(Windows) | IQ3_S | 短回复 +8.4% |
| RTX PRO 5000 | IQ3_S | 短回复 +6.23% |
| Apple M5 Max | IQ3_S | +3.8% |
| DGX Spark | IQ3_S | +5.8% |
但是,也不是没有代价。
DFlash2 与 MTP 对比
相比之下,MTP 在硬件兼容性和多并发下都有优势:
| 对比项目 | DFlash2 | MTP |
|---|---|---|
| 显存占用 | 约 625MiB | 约 5.2GB |
| 额外文件 | 首次下载约 1.2GB | 推测层约 5.2GB |
| 单请求生成速度 | 多数官方测试更快 | 部分硬件更快 |
| 多并发 | 主要面向单请求 | 更适合多请求 |
| 低显存设备 | 优势明显 | 显存压力较大 |
| 支持范围 | 依赖特定模型与引擎 | 兼容范围更广 |
| Strata 0.2.10 默认策略 | 单请求 Qwen3.8 优先 | 多并发等场景优先 |
两张显卡一起跑,代码编辑速度接近翻倍
针对多显卡,这次更新带来优化:All-cards Split Engine。
以前多显卡运行模型时,常见做法是将模型的不同层分配到不同显卡。新的方式则允许多张显卡共同处理每一层模型,让它们同时参与计算。
官方使用两张 RTX A6000,在 Linux 下运行 UD-Q4_K_XL,得到以下结果:
| 测试任务 | 原来的速度 | 新版速度 |
|---|---|---|
| 代码编辑 | 195 Token/s | 377~394 Token/s |
| 生成新代码 | 139~144 Token/s | 189~232 Token/s |
| 普通文本 | 93 Token/s | 139~146 Token/s |
| Agent 循环 | 112~119 Token/s | 165 Token/s |
代码编辑任务的生成速度几乎翻倍。
还加入了一个编程专用的 DeepSeek 模型
Strata 0.2.10 新增了 ISTA-DAS Coder。它基于 DeepSeek-V4.1-Flash,针对编程和 Agent 任务进行了专家裁剪,每层只保留原来 384 个专家中的 192 个。
这样可以减少需要处理的专家权重。
官方测试中:
- 单张 Radeon AI PRO R9700:22.8 Token/s。
- 四张 R9700:59.2 Token/s。
- Apple M5 Max:19.1~22.5 Token/s。
- RTX PRO 6000 Blackwell:约 100 Token/s。
如何安装 Strata
- 打开 终端(按 ⌘ + 空格,输入“终端”)。
- 如果还没安装 Homebrew,先运行下面这条安装命令。
- 运行下面这条命令:
最近 10 个版本记录
最近一次更新为 2026-11-09,当前版本 v0.2.13,共记录最近 10 个版本。
| 版本 | 发布日期 | 类型 | 大小 | macOS | Windows | Linux |
|---|---|---|---|---|---|---|
| v0.2.13 | 2026-11-09 | 稳定版 | 161.4 MB | 下载 | 下载 | 下载 |
| v0.2.12 | 2026-11-07 | 稳定版 | 161.1 MB | 下载 | 下载 | 下载 |
| v0.2.11 | 2026-11-05 | 稳定版 | 161.0 MB | 下载 | 下载 | 下载 |
| v0.2.10 | 2026-11-02 | 稳定版 | 160.8 MB | 下载 | 下载 | 下载 |
| v0.2.9 | 2026-10-31 | 稳定版 | 160.3 MB | 下载 | 下载 | 下载 |
| v0.2.8 | 2026-10-29 | 稳定版 | 160.2 MB | 下载 | 下载 | 下载 |
| v0.2.7 | 2026-10-27 | 稳定版 | 160.2 MB | 下载 | 下载 | 下载 |
| v0.2.6 | 2026-10-25 | 稳定版 | 159.0 MB | 下载 | 下载 | 下载 |
| v0.2.5 | 2026-10-25 | 稳定版 | 159.1 MB | 下载 | 下载 | 下载 |
| v0.2.4 | 2026-10-24 | 稳定版 | 158.7 MB | 下载 | 下载 | 下载 |
数据来自 GitHub Releases,稳定版优先,同类按发布时间排序。
与同类应用对比
只对比公开元数据,不做主观推荐;需要逐项对比时见对比页。
| 应用 | 版本 | 许可证 | 架构 | 近 30 天安装 |
|---|---|---|---|---|
| Strata | v0.2.13 | MIT | 通用二进制 | 0 |
| Codex | rust-v0.169.0 | — | 通用二进制 | 417,825 |
| ollama | v0.40.16 | MIT | 命令行 | 63,182 |
| Claude Code | 2.1.308 | — | 通用二进制 | 60,329 |
AI 与机器学习中的类似应用

Codex
Codex 是 OpenAI 推出的本地编码智能体,直接运行在你自己的电脑上。它的核心形态是 Codex CLI 命令行工具,同时也提供 VS Code、C…ollama
Claude Code
Claude Code 是 Anthropic 推出的 AI 编程助手,把终端和 IDE 变成了能理解你代码的协作环境。llama.cpp
llama.cpp 是一个用纯 C/C++ 实现的大语言模型与视觉语言模型推理引擎,目标是在尽量少的配置下,让模型在本地或云端多种硬件上高效运行。
ggml
ggml 是一个面向机器学习的张量库,目标是做到简单、可移植且高效,并且几乎不需要额外配置。rtk
rtk 是一个面向 AI 编程助手的成本压缩工具。它的核心思路很直接:在助手读取命令输出之前先做压缩。所属分类:AI 与机器学习